대규모 언어모델(LLM)이 단순히 파라미터에 저장된 지식만으로 답변하는 것이 아니라, 외부 지식 저장소(Vector DB 등)에서 관련 문서를 검색하여 함께 활용하는 방식
RAG가 필요한 이유
- LLM은 최신 정보나 특정 전문 지식을 잘 모를 수 있음.
- 훈련 데이터에 없는 정보는 잘못된 답(환각, hallucination)을 할 수 있음.
- 외부 지식을 불러와 답변하면 정확성, 신뢰성, 최신성이 높아짐.
쉽게 사전에 필요한 부분 학습? 한다 생각하면 될것 같다.
1. Embedding Model (임베딩 모델)
텍스트를 숫자 벡터(고차원 공간의 좌표)로 변환하는 모델.
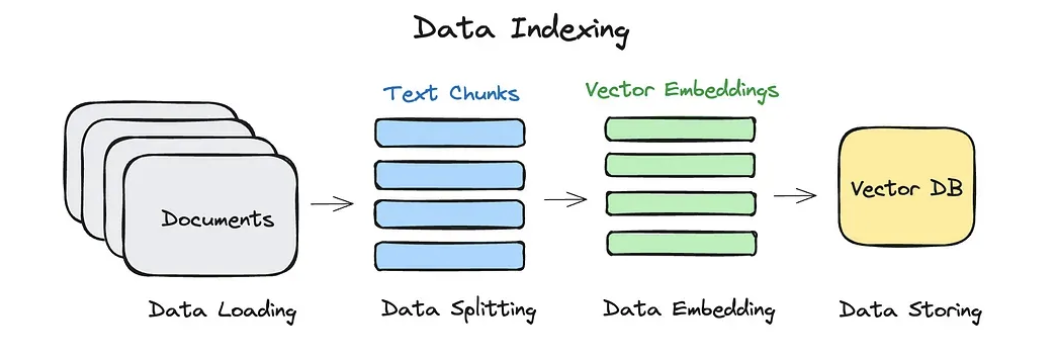
아래 flow 에서는 chunk를 -> vetor 로 Embedding Model 을 통해 변환 저장
이렇게 변환된 벡터는 의미적으로 가까운 문장은 벡터 공간에서도 서로 가깝게 배치된다.
- 예시:
- "강아지"와 "개의 사진"은 유사한 의미 → 벡터 간 거리 가까움
- "강아지"와 "자동차"는 의미가 다름 → 벡터 간 거리 멀어짐
2.Vector Store - 문서 벡터 저장 및 검색을 위한 인터페이스
벡터 저장소는 이베딩된 문서 저장하고, 질문과 유사한 문서를 빠르게 검색해주는 핵심 컴포넌트.
3.Vector DB - 대규모 벡터 데이터를 효율적으로 관리하고, 최근접 이웃 검색(Nearest Neighbor Search) 등을 빠르게 수행할 수 있는 데이터베이스.
4.TokenTextSplitter - 긴 문서를 잘라서 모델이 처리하기 쉽게 토큰 단위로 분할하는 도구.
- 모델마다 한 번에 처리 가능한 context length(맥스 토큰 수)가 정해져 있기 때문
5.Chunk - 잘라낸 텍스트 조각
- 예: 10,000자 문서를 500자씩 나누면 20개의 chunk 생성
- 각 chunk는 임베딩 벡터로 변환 후 Vector DB에 저장됨.
청크로 조각을 낼떄 중요한 이유는 문소를 그대로 젖아하면 너무 길어서 검색/ 처리 불가
chunk 단위로 나누면 LLM이 필요한 부분만 뽑아 활용 가능
RAG flow
Basic RAG pipeline
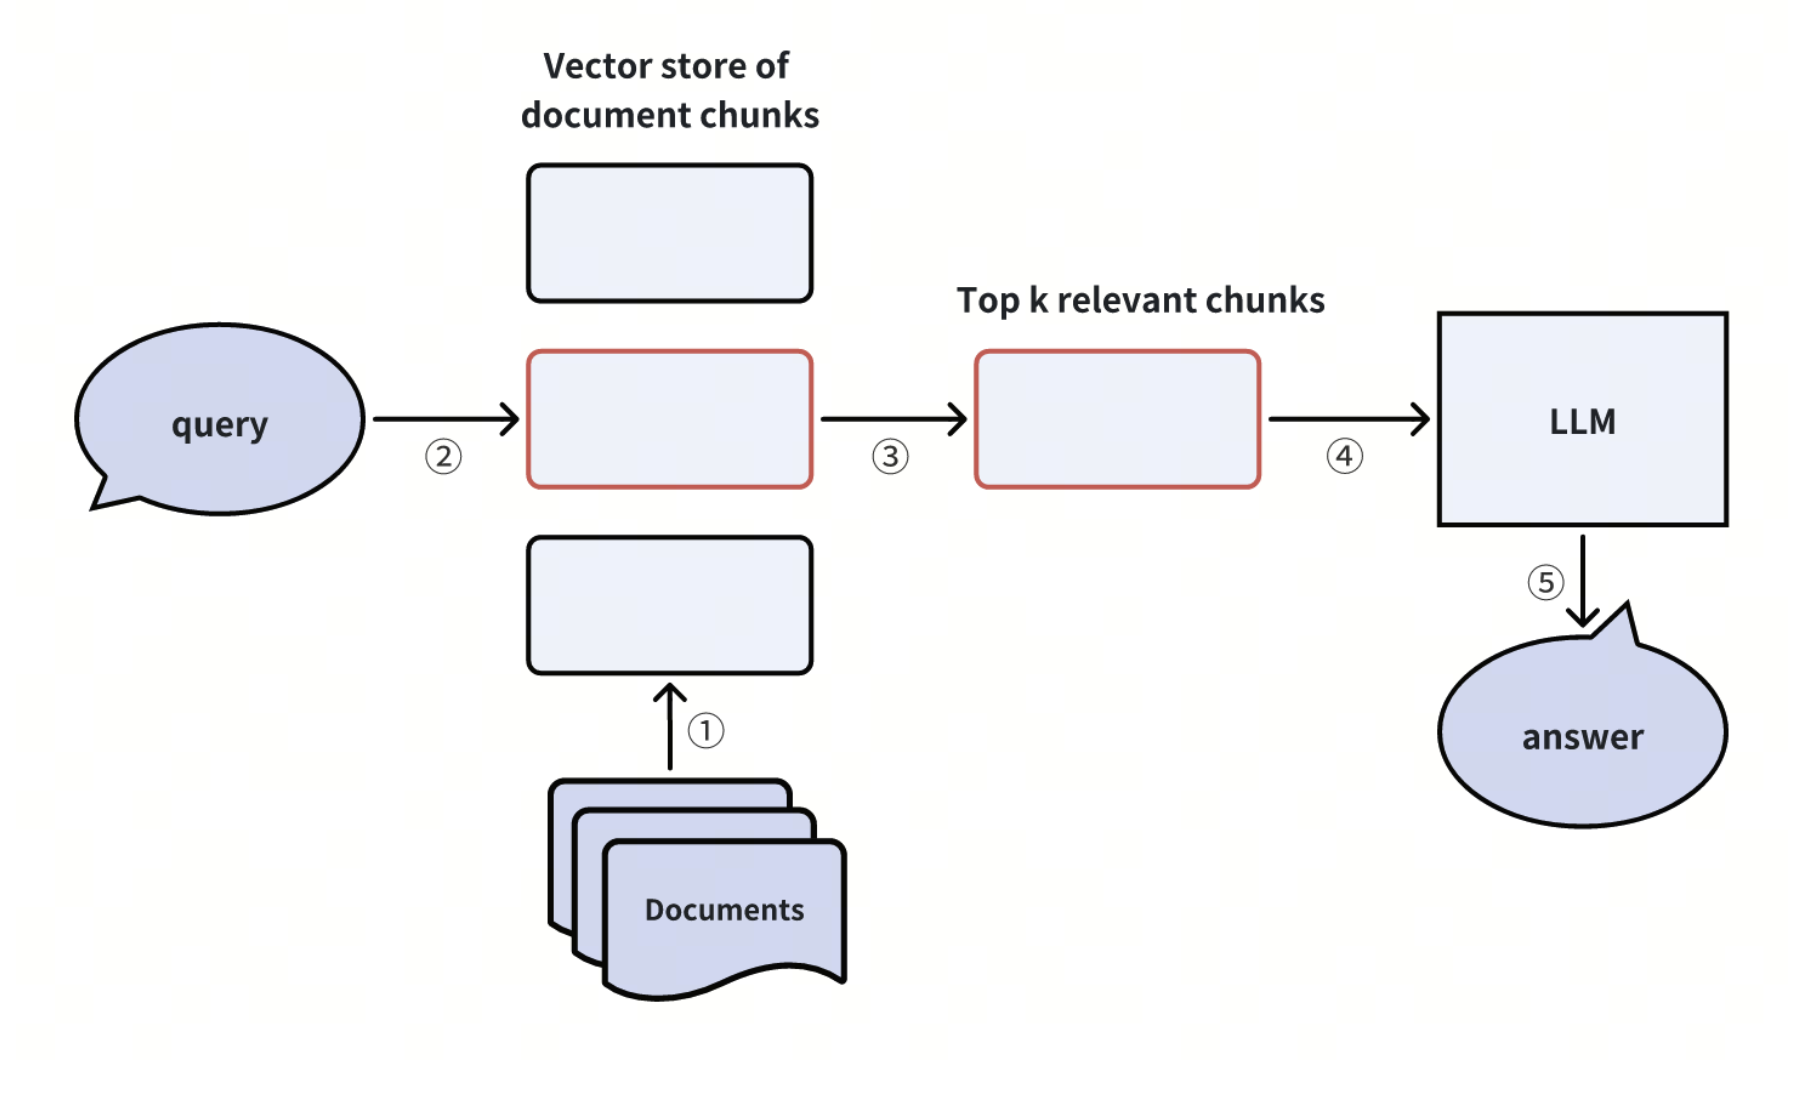
이미지랑 간단한 실습으로는 아주 어렵다는 생각은 들지 않지만 역시 내요 자체가 생소하다보니 학습에서 멈추기 보다는 업무에도 녹일 수 있는 일이 있으면 좋을것 같다.
'코드 > dev' 카테고리의 다른 글
| 클라우드 컨테이너 오케스트레이션 서비스: ECS, EKS (0) | 2025.09.05 |
|---|---|
| Kafka에서 메시지를 신뢰성 있게 다루는 방법 (0) | 2025.09.03 |
| Spring AI LLM(Prompt, ChatModel, ChatOptions) (1) | 2025.08.30 |
| Domain과 service의 차이 (0) | 2025.08.29 |
| Entity와 Domain의 차이 (5) | 2025.08.29 |