728x90

상품 검색을 개선하면서 MySQL N-Gram의 동작 방식을 다시 살펴보게 됐다. 이번 글에서는 기본 원리와 간단한 SQL 예제, 그리고 기존 상품 검색에서 아쉬웠던 점을 정리해보려고 한다.

1. N-Gram은 문자열을 어떻게 나눌까?
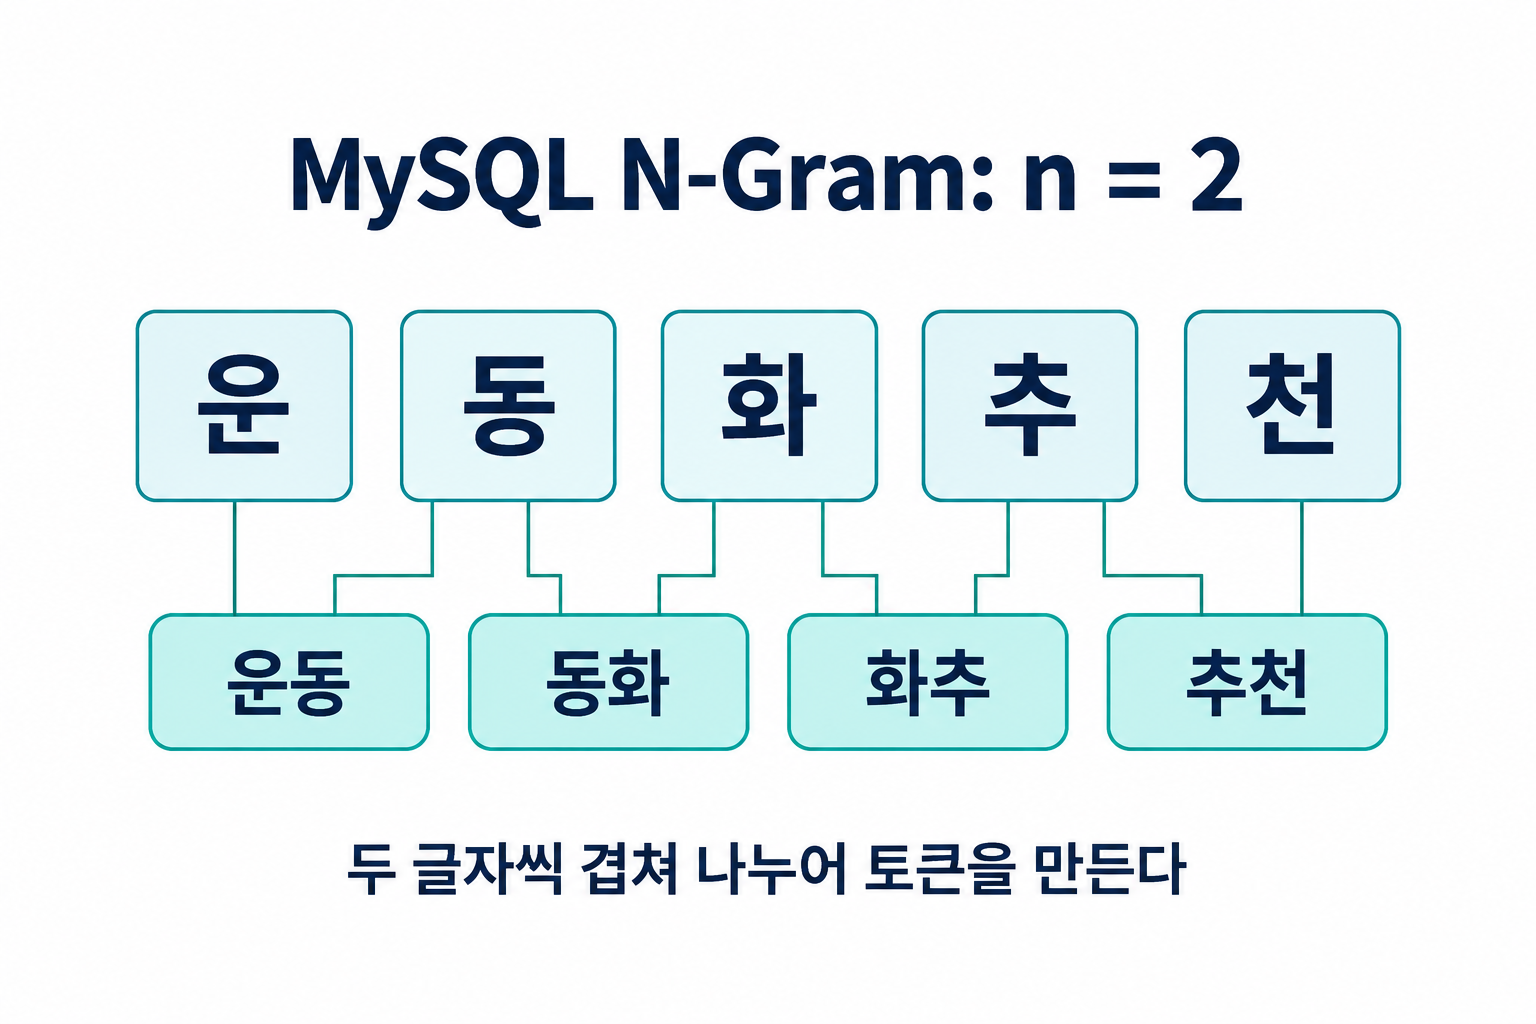


N-Gram은 연속된 n개의 문자를 하나의 토큰으로 나누는 방식이다. MySQL은 한글을 포함한 CJK 텍스트 검색을 위해 ngram 파서를 제공하며, FULLTEXT 인덱스에 적용할 수 있다.

예를 들어 n=2일 때 ‘운동화추천’은 ‘운동’, ‘동화’, ‘화추’, ‘추천’으로 나뉜다. 두 글자씩 끊어 버리는 것이 아니라, 한 글자씩 이동하면서 겹치는 조각을 만든다.

이때 ‘동화’나 ‘화추’가 생기는 것을 보면 알 수 있듯, 단어의 의미를 이해해 나누는 방식은 아니다.

2. 두 글자 검색만 가능한 것은 아니다

ngram_token_size의 기본값은 2다. 하지만 이것은 검색어를 반드시 두 글자로 입력해야 한다는 뜻이 아니라, 인덱스를 구성하는 토큰의 길이가 2라는 뜻이다. ‘운동화’처럼 더 긴 검색어도 여러 토큰으로 나누어 처리한다.

반대로 토큰보다 짧은 한 글자 검색은 일반적인 검색에서 제약이 있다. 검색 결과를 확인할 때는 토큰 크기와 검색 모드를 함께 봐야 한다.

3. 간단한 상품 검색 예제

아래는 운영 코드를 단순화한 것이 아니라, 검색 대상 컬럼의 차이를 설명하기 위해 만든 예제다. MySQL 8.4 문서를 기준으로 작성했으며 실제 DB에서 실행 검증한 결과는 아니다.

CREATE TABLE product_search_demo (
  id BIGINT PRIMARY KEY,
  name VARCHAR(200),
  keywords TEXT,
  FULLTEXT INDEX ft_keywords (keywords) WITH PARSER ngram
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO product_search_demo VALUES
  (1, '가벼운 운동화', '운동화 러닝화'),
  (2, '가벼운 운동화', '신발');

SELECT id, name
FROM product_search_demo
WHERE MATCH(keywords)
      AGAINST('운동화' IN BOOLEAN MODE);

이 예제에서는 상품명에 ‘운동화’가 있어도 검색 대상은 keywords뿐이다. 따라서 2번 상품은 상품명만으로 검색에 잡히지 않는다. N-Gram이 다른 컬럼의 내용을 알아서 검색해 주는 것은 아니다.

4. 검색 모드도 확인해야 한다

자연어 모드는 검색어에서 나온 N-Gram 토큰들의 합집합을 기준으로 검색한다. Boolean 모드는 검색어를 N-Gram 구문 검색으로 변환한다. 같은 검색어라도 모드에 따라 매칭 범위가 달라질 수 있으므로, 실제 상품 데이터로 결과를 비교해보는 것이 좋다.

5. 실무에서 가장 아쉬웠던 점

기존 시스템도 검색용 키워드를 별도 컬럼에 저장하고 해당 컬럼을 검색하는 구조였다. 가장 아쉬웠던 점은 상품이 있어도 검색에 필요한 키워드가 없으면 결과에 나오지 않는다는 것이었다.

사용자가 입력할 만한 표현을 미리 등록해야 하다 보니 검색 품질이 키워드 관리에 많이 의존했다. 당시 사용하던 2글자 단위 설정의 제약도 있었지만, 키워드 누락은 토큰 크기와는 별개의 문제였다.

예를 들어 ‘러닝화’를 검색했을 때 ‘운동화’라는 키워드만 가진 상품까지 찾고 싶다면, 단순한 문자 분할 외에 두 표현을 연결하는 규칙이 필요하다. 이 예시는 기존 방식의 한계를 설명하기 위한 가상의 상황이다.

마무리

MySQL N-Gram은 DB 안에서 텍스트 검색을 구현할 수 있는 선택지다. 다만 토큰을 나누는 방식만큼 검색 대상 데이터와 검색 모드도 중요하다.

내 경우에는 키워드를 계속 추가하는 것에서 나아가, 어떤 상품 정보를 검색 대상으로 삼고 검색어를 어떻게 처리할지 다시 고민하게 됐다. 이후 OpenSearch로 전환했지만, 엔진 교체만으로 키워드 누락이 해결되는 것은 아니다. 검색에 넣을 데이터와 분석 방식을 함께 설계하는 것이 핵심이었다.

참고: MySQL 8.4 공식 문서 — ngram Full-Text Parser

728x90
728x90

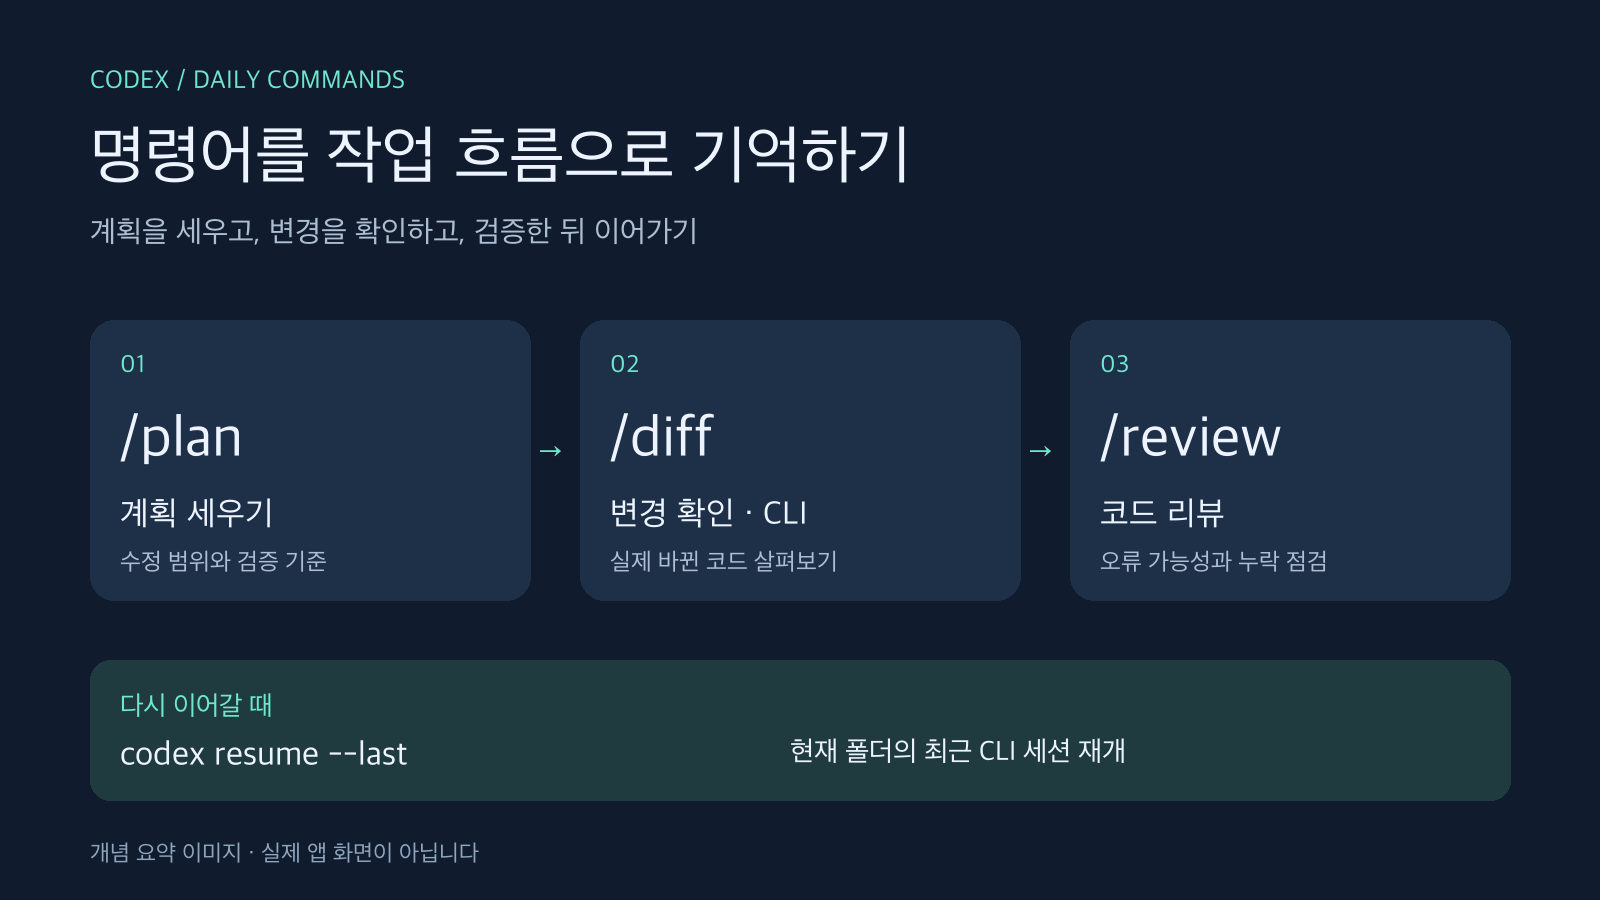
Notion에 모아둔 Codex 메모에서 개발 중 다시 찾아보기 좋은 명령어를 추렸다. 명령어를 전부 외우기보다, 작업을 시작하고 변경을 확인하고 다음 날 이어가는 흐름으로 정리했다.

확인 기준: 2026년 10월 14일 · 앱과 CLI는 사용 가능한 명령과 동작이 다를 수 있다. 입력창에 /를 입력해 현재 환경의 목록을 확인하자.

1. /plan — 수정 전에 계획부터

여러 단계가 필요한 작업에서 계획 모드를 켜거나 끌 때 사용한다. 요구사항이 모호하다면 수정 범위와 검증 방법부터 정리해 두면 좋다.

예시 요청: 주문 조회 로직을 리팩토링하려고 해. 현재 의존성과 변경할 파일, 기존 동작을 확인할 테스트를 먼저 정리해줘.

2. /review — 변경 사항을 한 번 더 점검하기

코드 리뷰를 시작하는 명령이다. 앱에서는 커밋하지 않은 변경이나 기준 브랜치와의 비교를 대상으로 삼을 수 있다. 리뷰 결과는 확인할 후보로 보고, 실제 코드와 테스트 결과를 함께 살핀다.

예시 요청: 정상 흐름 외에 빈 결과, 중복 요청, 외부 API 실패 시 처리를 중심으로 확인해줘.

3. /status와 /model — 현재 상태와 모델 확인

/status로 대화 상태와 사용량 관련 정보를 확인하고, /model로 사용할 모델을 선택한다. 작업을 시작할 때 한 번 확인해 두면 다른 설정으로 진행하고 있지는 않은지 점검하기 좋다.

4. /diff — 실제 변경 코드 확인하기 [CLI]

CLI에서 Git diff를 확인하는 명령이다. 설명만 읽고 넘어가지 않고, 의도하지 않은 파일 변경이나 빠진 조건이 없는지 직접 확인하는 데 쓴다.

예를 들어 검색 조건 변경 시 페이지를 초기화했다면, 검색어를 유지한 채 다음 페이지로 이동하는 동작도 여전히 맞는지 확인한다. /review로 받은 지적과 /diff의 실제 변경을 함께 보면 판단하기 쉽다.

5. codex resume --last — 작업 이어가기 [터미널]

CLI를 종료한 뒤에는 프로젝트 폴더에서 다음 명령을 실행해 현재 폴더의 가장 최근 대화를 이어갈 수 있다.

codex resume --last

이 명령은 대화 입력창의 슬래시 명령이 아니라 터미널에서 실행한다. --last는 하이픈 두 개다. 이전 대화 중에서 고르고 싶다면 codex resume를 실행하면 된다.

명령어 다음에는 검증 기준을 남기기

계획 → 구현 요청 → 변경 확인 → 리뷰 → 테스트 순서로 사용해 보자. 명령어는 작업을 시작하는 수단이고, 완료 여부는 검증 결과로 판단해야 한다. “수정해줘”에 더해 “어떤 동작을 유지해야 하는지, 무엇을 확인하면 완료인지”까지 적는 것이 핵심이다.

예를 들어 “중복 요청에도 주문이 한 번만 생성되는지 확인하고, 실행한 테스트와 남은 한계를 알려줘”처럼 결과를 확인할 기준을 요청에 담을 수 있다.


참고: OpenAI 공식 앱 슬래시 명령어 · OpenAI 공식 CLI 명령어


Developer commands | ChatGPT Learn

Reference for commands and slash commands in Codex developer surfaces

learn.chatgpt.com


728x90
728x90

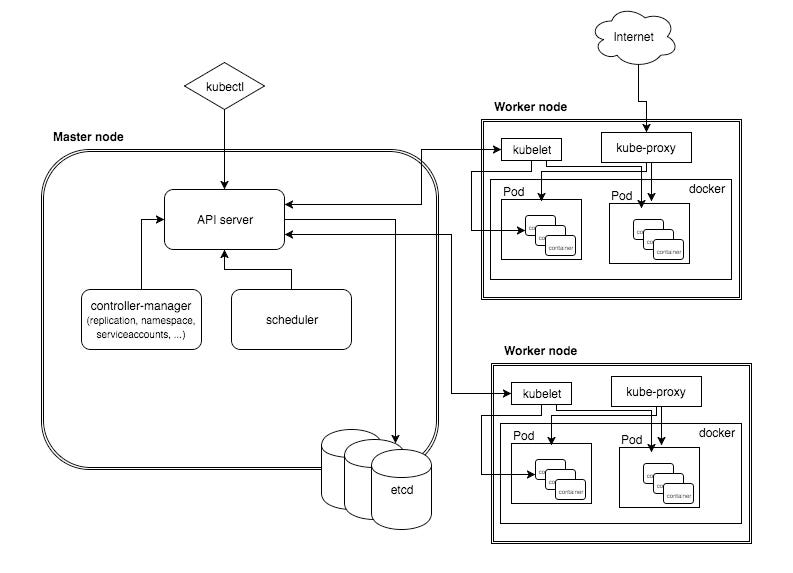
Kubernetes를 처음 공부하면 가장 헷갈리는 부분이 Control Plane과 Data Plane의 역할 차이다.

minikube로 실습하면서 구조를 직접 확인해보고 나서야 전체 그림이 정리됐다.


Kubernetes는 크게 다음 2가지 영역으로 나뉜다.


Control Plane (Master Node)
Data Plane (Worker Node)


1. Control Plane (Master Node)

클러스터 전체를 통제하고 관리하는 영역 “두뇌 역할”을 한다고 보면 된다.

1-1 .kube-apiserver


✔ Kubernetes의 모든 요청이 들어오는 관문(Gateway)

✔ kubectl 명령어도 결국 API Server로 요청을 보낸다.


→ kubectl → kube-apiserver → etcd 조회 → 결과 반환


즉, 모든 컴포넌트는 직접 통신하지 않고

반드시 kube-apiserver를 통해서만 통신한다.

Kubernetes의 “중앙 통제 허브”

1-2. etcd

✔ 클러스터의 모든 상태 정보 저장소 (Key-Value DB)

✔ 분산 환경에서도 일관성 보장


저장되는 정보 예:

  • Pod 정보
  • Deployment 설정
  • Service 설정
  • ConfigMap / Secret


중요한 점:

Kubernetes는 “현재 상태”가 아니라

“원하는 상태(Desired State)”를 etcd에 저장한다.


그리고 이 상태를 맞추기 위해 컨트롤러들이 계속 동작한다.

1-3. kube-scheduler

✔ 새로 생성된 Pod를

✔ 어떤 Worker Node에 배치할지 결정


기준:

  • CPU / Memory
  • Node 리소스 상황
  • Taints / Tolerations
  • Affinity / Anti-affinity

ex) 3개의 Pod를 → 어떤 노드에 배치할지 판단하는 게 Scheduler 역할

1-4.kube-controller-manager


✔ 클러스터 상태를 지속적으로 감시

✔ “현재 상태”와 “원하는 상태”를 맞추는 역할


예:

  • ReplicaController
  • DeploymentController
  • NodeController
  • JobController


예시 상황:

Pod 3개 유지해야 하는데 1개가 죽었다


→ Controller가 감지

→ 새 Pod 생성

→ 상태 복구


1-5.cloud-controller-manager

✔ AWS, GCP 같은 클라우드 환경 연동 담당

✔ LoadBalancer, Volume, Node 연동 처리


minikube에서는 거의 체감이 없다.

EKS 같은 환경에서 중요해진다.


2.  Data Plane (Worker Node)

실제 애플리케이션이 배포되는 영역 “몸통 역할”


2-1.kubelet

✔ 각 Worker Node에서 실행

✔ Control Plane과 통신

✔ Pod 실행 및 상태 보고


kubelet은 다음을 수행한다:

  • API Server에서 Pod 스펙을 받아옴
  • Container Runtime에게 컨테이너 실행 요청
  • Pod 상태를 API Server에 보고

즉, 노드의 대리인 역할.


2-2. container runtime


✔ 실제로 컨테이너를 실행하는 엔진

예:

  • containerd
  • CRI-O
  • (예전에는 Docker)

minikube에서는 보통 containerd 사용


흐름: kubelet → container runtime → 컨테이너 실행


2-3 kube-proxy

✔ 네트워크 라우팅 담당

✔ Service가 Pod로 트래픽을 전달할 수 있도록 처리


흐름 

Service (ClusterIP)
   ↓
kube-proxy가 iptables/ipvs 설정
   ↓
실제 Pod로 트래픽 전달


Service가 Pod를 직접 찾는 게 아니라

kube-proxy가 네트워크 규칙을 만들어주는 구조다.


전체 흐름 정리

Pod를 하나 생성한다고 가정해보자.


kubectl apply -f deployment.yaml

1️⃣ kubectl → kube-apiserver

2️⃣ apiserver → etcd에 desired state 저장

3️⃣ scheduler → Pod를 어느 노드에 배치할지 결정

4️⃣ kubelet → container runtime에게 실행 요청

5️⃣ kube-proxy → 네트워크 설정

6️⃣ Controller → 상태 계속 감시


이 모든 과정이 자동으로 돌아간다.

728x90
728x90

쿠버네티스(Kubernetes)는 컨테이너화된 애플리케이션을 자동으로 배포, 스케일링, 운영해주는 오픈소스 플랫폼입니다. 처음 접하면 용어와 개념이 낯설 수 있지만, 기초부터 차근차근 익히면 효율적으로 활용할 수 있습니다. 이번 글에서는 초보자를 위한 쿠버네티스의 핵심 개념 7가지를 소개합니다.


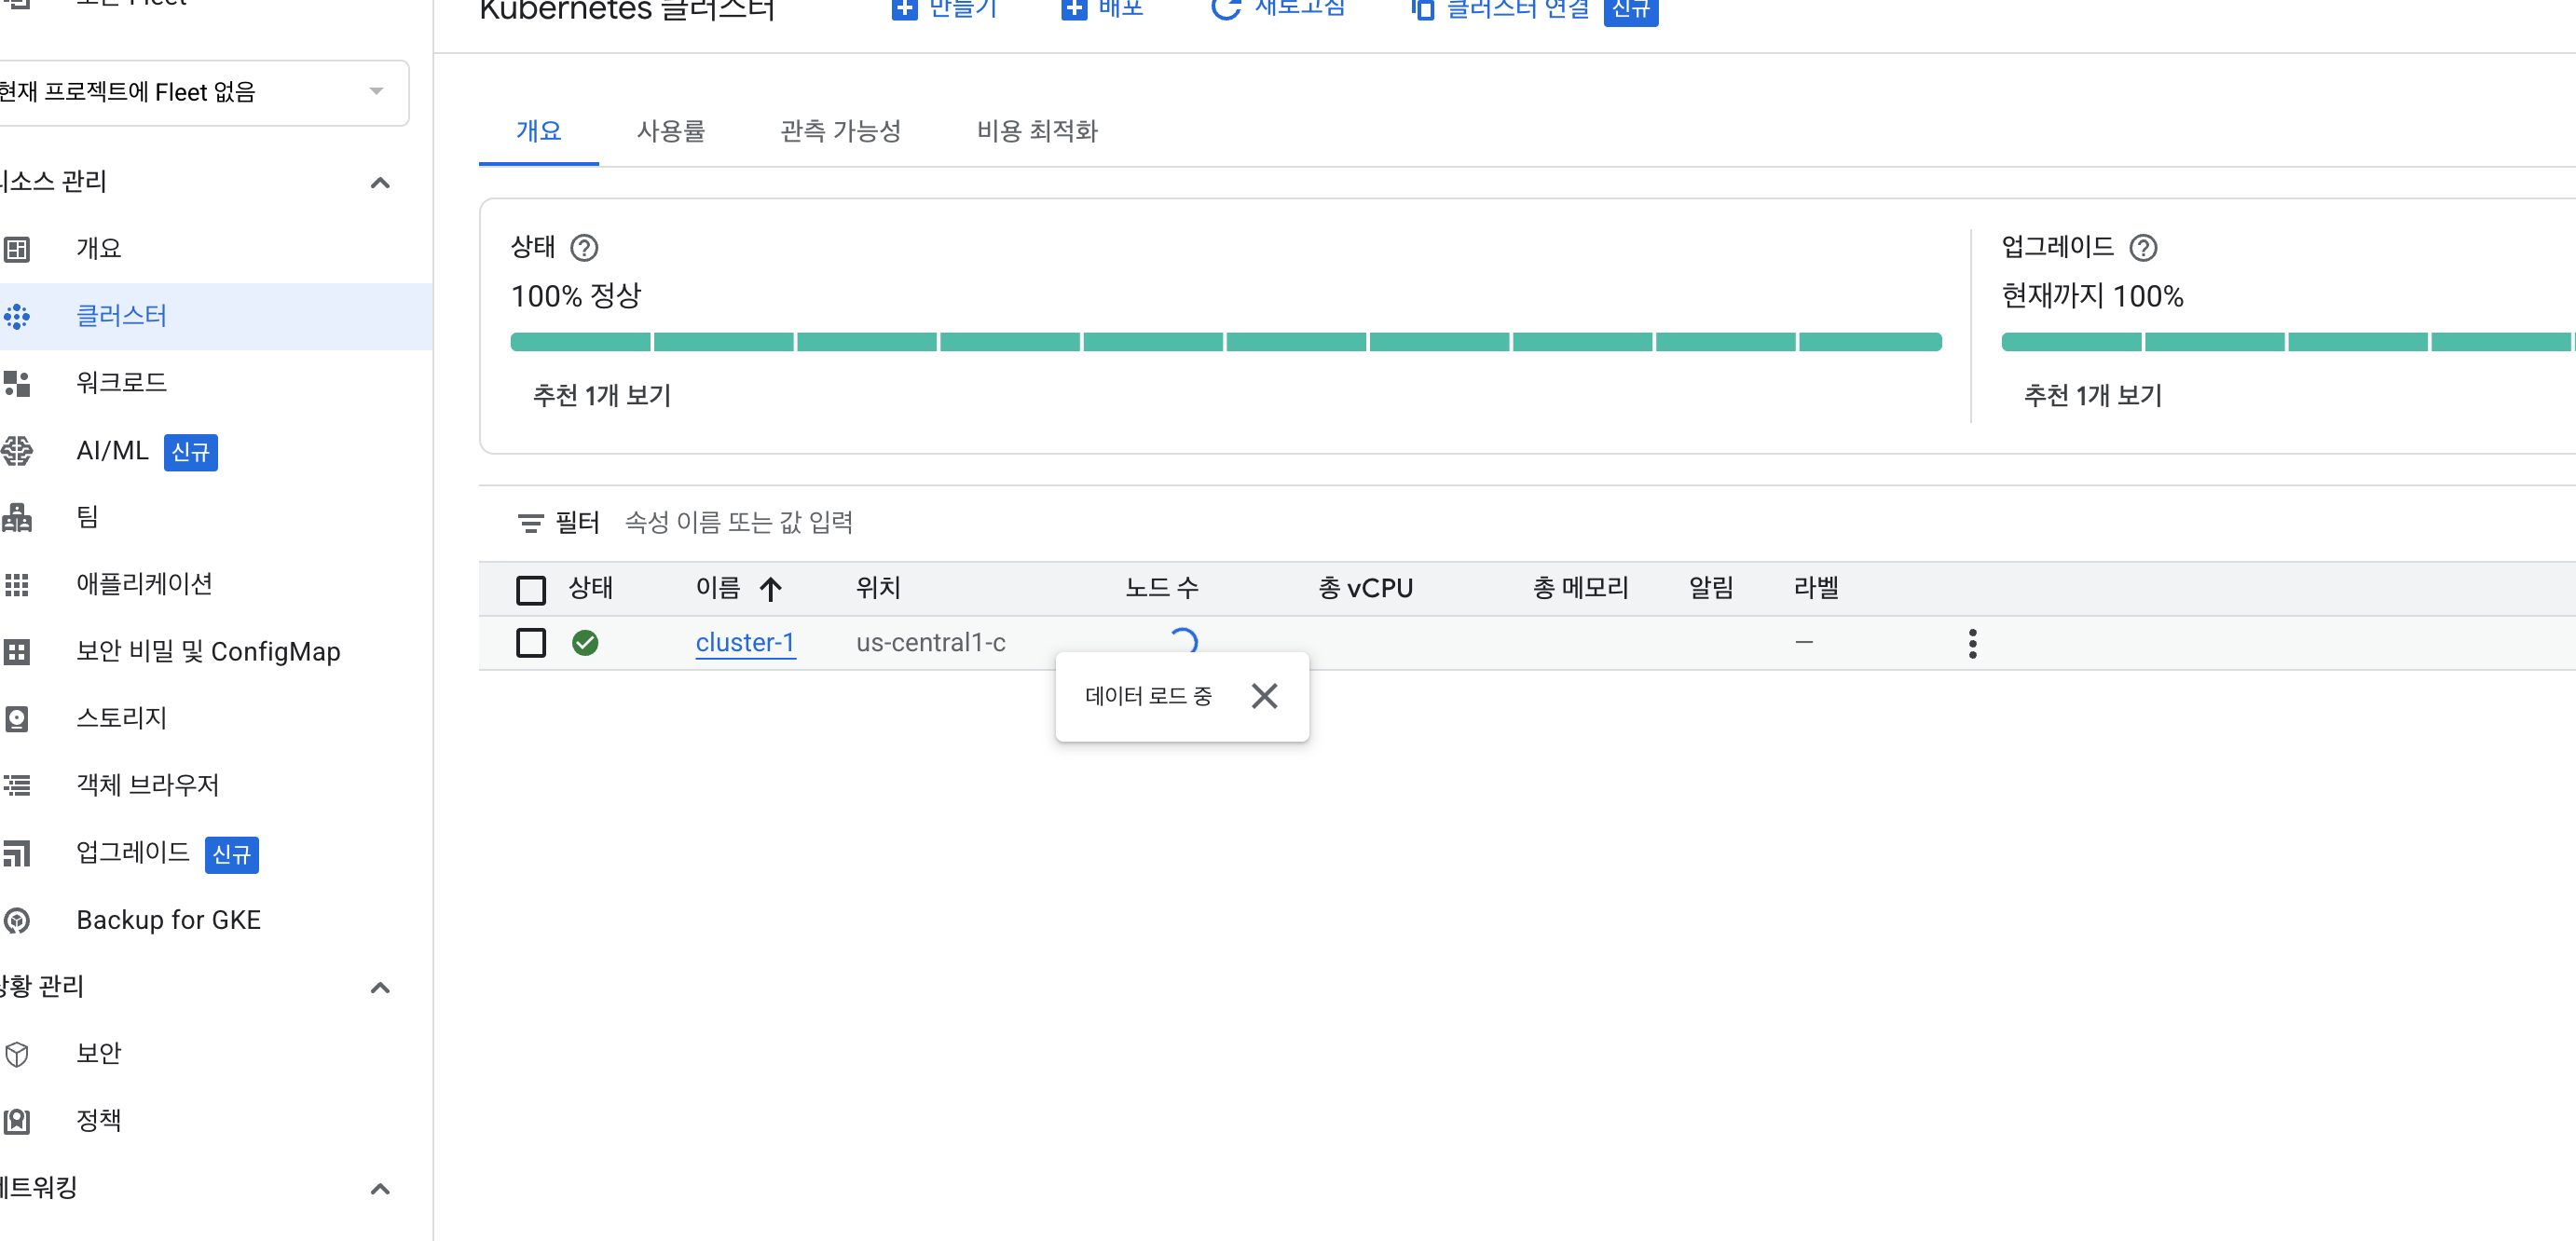
쿠버네티스 환경 실습및 학습을 위해  GCP  90일 무료 크레딧을 통해  진행할 수 있다.

실제 GCP EKS 클러스터


1. kubectl – 쿠버네티스와 대화하는 터미널 도구


kubectl은 쿠버네티스를 조작할 수 있는 커맨드라인 도구입니다. 마치 서버 관리자와 대화하는 창구 역할


kubectl get pods
kubectl apply -f deployment.yaml
kubectl describe node <노드이름>

쿠버네티스 클러스터에 명령을 보내 리소스를 생성하거나 상태를 조회할 수 있다.


2. Label – 리소스를 구분짓는 이름표


label은 쿠버네티스의 리소스(Pod, Node 등)에 붙이는 키-값 쌍입니다. 이걸 이용하면 리소스를 그룹화하거나 특정 기준으로 검색할 수 있다.

--  yaml  설정중  label  예시

labels:
  app: myapp
  env: production

이렇게 라벨을 붙여두면 원하는 Pod를 효율적으로 찾아서 작업이 가능


3. Selector – 라벨로 리소스를 찾는 방법


selector는 위에서 설명한 label을 기준으로 리소스를 선택하는 방법입니다. 대표적으로 ReplicaSet이나 Service가 Selector를 통해 연결 대상을 찾는다.

selector:
  matchLabels:
    app: myapp


즉, app=myapp 라벨이 붙은 Pod를 대상으로 동작


4. Node – 쿠버네티스 클러스터의 일꾼


Node는 실제 애플리케이션이 실행되는 서버이다. 쿠버네티스 클러스터는 하나 이상의 Node로 구성되어 있으며, 각 Node는 여러 Pod를 실행할 수 있다.

kubectl get nodes

명령어로 클러스터에 어떤 Node가 있는지 확인가능


5. nodeSelector – 특정 노드에 Pod 배치하기

기본적으로 쿠버네티스는 적절한 Node를 자동으로 선택하지만, 특정 Node에 Pod를 배치하고 싶을 때는 nodeSelector를 사용

spec:
  nodeSelector:
    disktype: ssd

이 설정을 통해 disktype=ssd 라벨이 붙은 Node에만 Pod가 배치


6. Replica – 애플리케이션의 복제 개수

애플리케이션의 안정성과 확장성을 위해 같은 Pod를 여러 개 복제할 수 있습니다. 이 개수를 설정하는 것이 바로 replicas


spec:
  replicas: 3


위와 같이 설정하면 동일한 Pod가 3개 실행되며, 하나가 죽어도 나머지가 서비스를 유지


7.YAML – 쿠버네티스 리소스 정의 파일

쿠버네티스에서 리소스는 주로 YAML 파일로 정의됩니다. 사람이 읽기 쉬운 구조이며, 선언형 방식으로 리소스의 상태를 명시한다.


apiVersion: v1
kind: Pod
metadata:
  name: mypod
spec:
  containers:
  - name: mycontainer
    image: nginx


YAML은 리소스를 생성할 때 매우 중요한 포맷


쿠버네티스라는것을 사용할때 기본적으로 속성으로 알고 가면 좋을것들을 정리해 봤는데 두서 없이 정리하다보니  아쉽지만 보통 구축된 곳을가면 가장 신경?을 많이써서 보는곳이  replica 관련 속성이다. 이와 관련 된 부분을 잘 보면 좋을것 같다.

728x90
728x90


마이크로서비스 아키텍처에서는 하나의 요청이 여러 서비스를 거쳐 처리됩니다. 이때, 특정 서비스에서 오류가 발생하면 단순히 로그만으로는 문제의 근본 원인을 파악하기 매우 어렵다. Jaeger의 트레이스 데이터로 전체 흐름을 파악하고, Kibana의 상세 로그로 특정 시점의 오류를 분석할 수 있다면 디버깅 시간을 획기적으로 줄일 수 있다.


로컬 테스트를 하기위해 docker compose 를 활용하여 실행 예정(docker desktop)


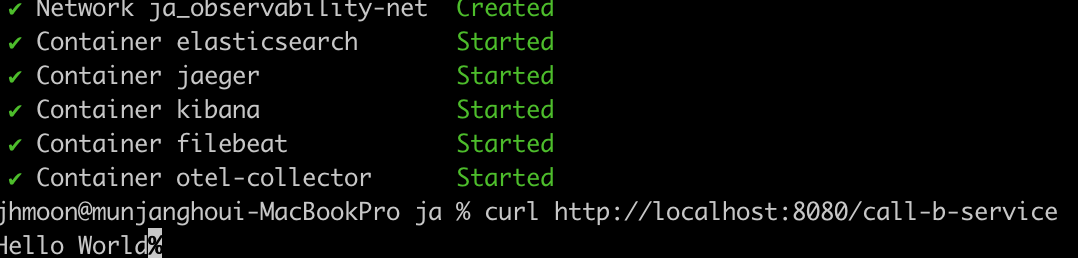
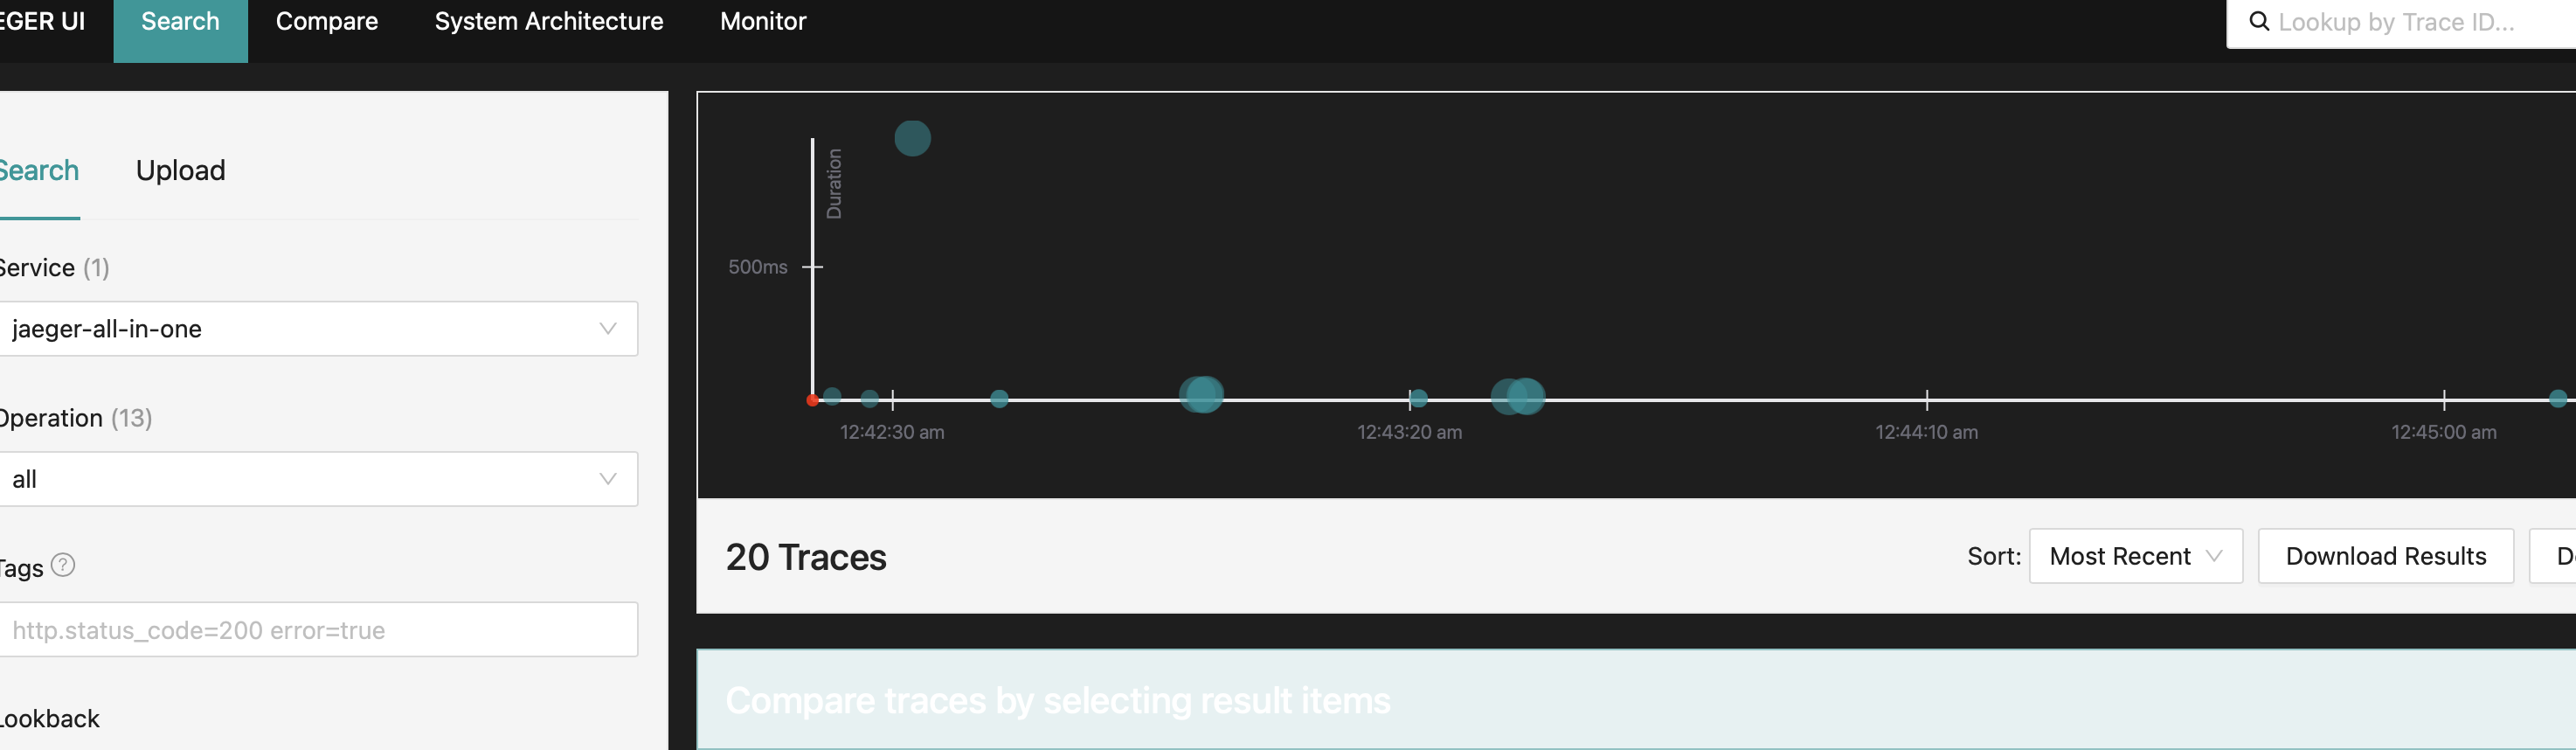
아래는  contianer 실행 및 임시로 만든 서비스로  호출 테스트를 진행하는 부분이다.


1. 목표 아키텍처 


  • OpenTelemetry로 애플리케이션의 트레이스 데이터와 로그를 생성합니다.
  • Jaeger는 트레이스 데이터를 수집하여 Elasticsearch에 저장합니다.
  • Filebeat는 애플리케이션 로그 파일을 읽어 Elasticsearch로 전송합니다.
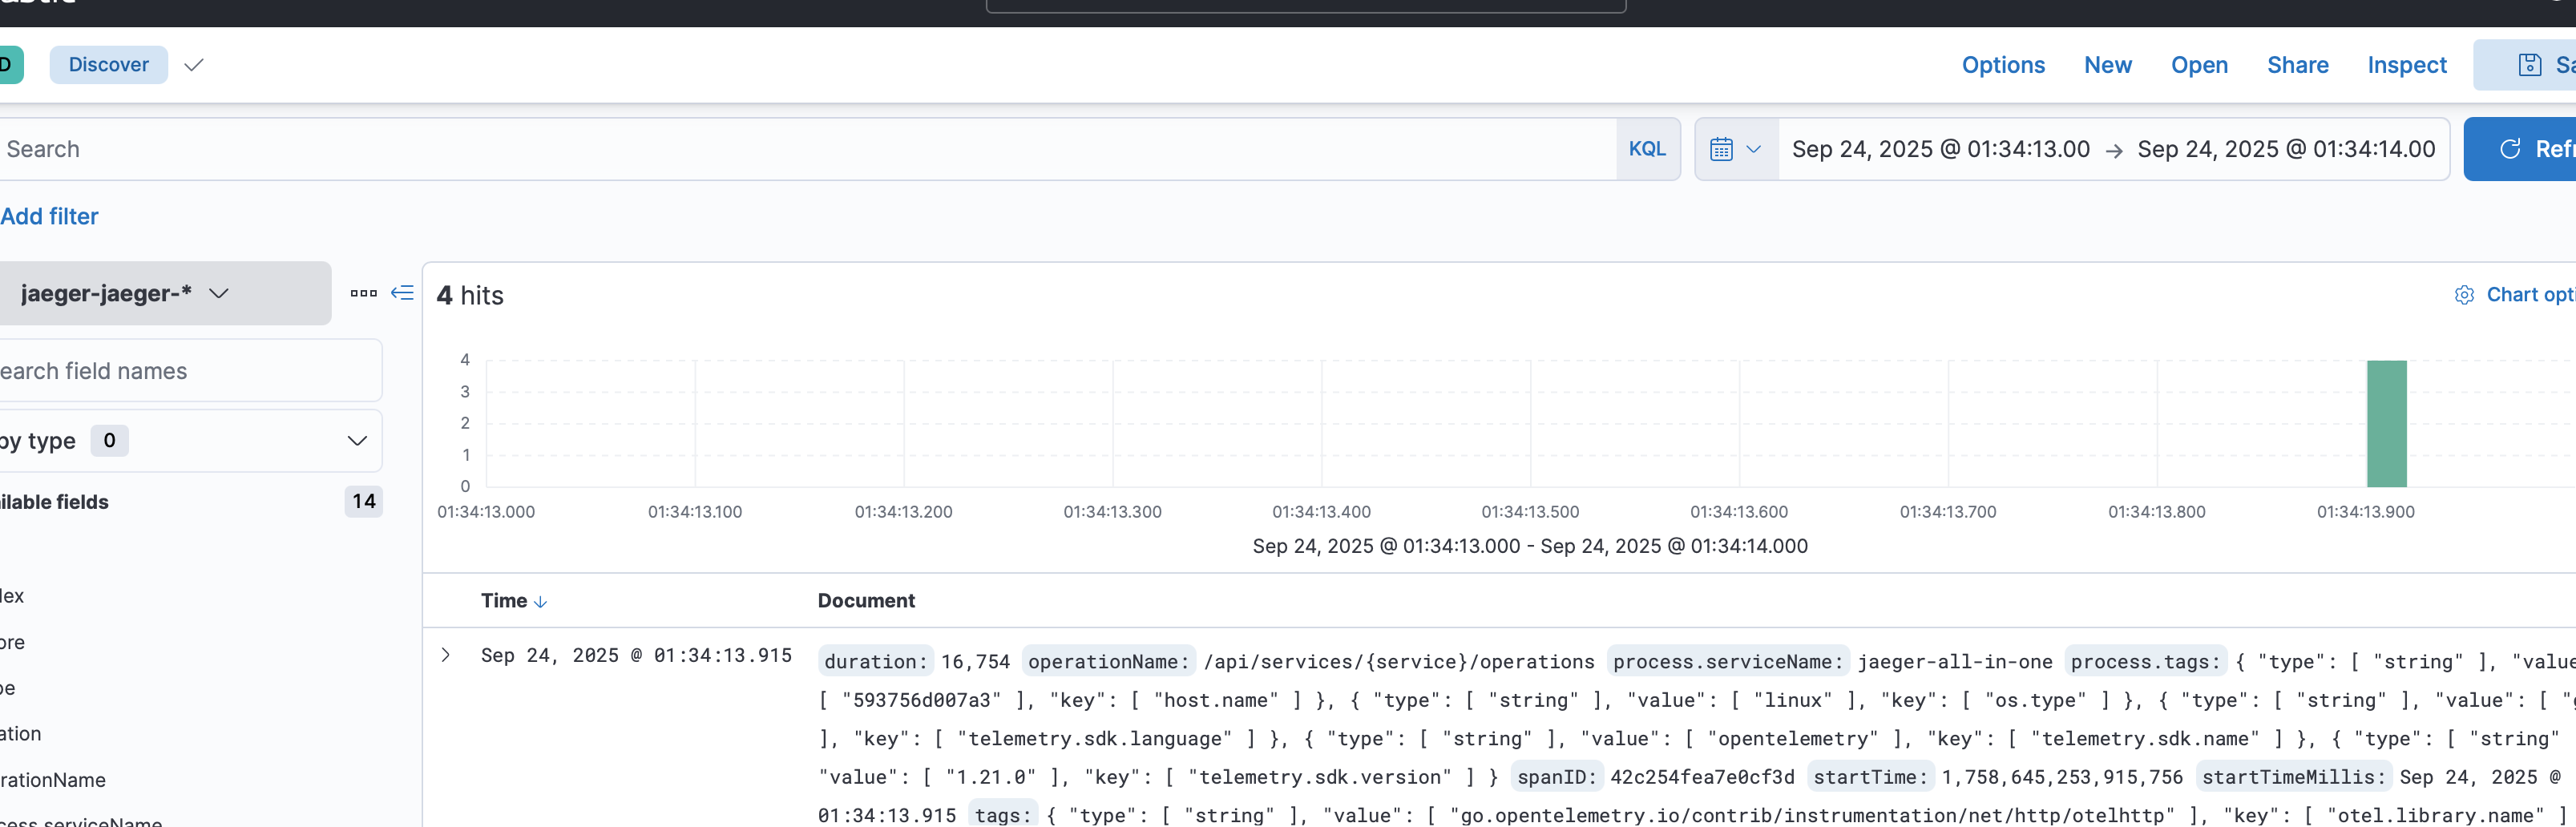
  • Kibana를 통해 Elasticsearch에 저장된 트레이스(Jaeger)와 로그(Filebeat) 데이터를 통합하여 분석합니다.


2. Docker compose 구성


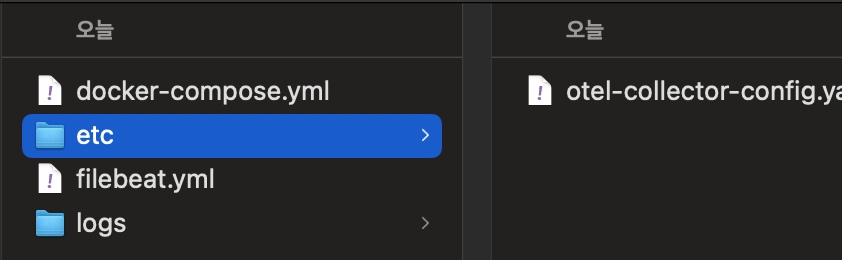
모든 컴포넌트를 로컬에서 쉽게 실행할 수 있도록 docker-compose.yml 파일을 작성

이 파일은 Elasticsearch, Kibana, Jaeger, OpenTelemetry Collector, 그리고 Filebeat 컨테이너를 정의합니다.

  • jaeger: SPAN_STORAGE_TYPE을 elasticsearch로 설정하여 트레이스 데이터를 Elasticsearch에 보냅니다.
  • filebeat: 애플리케이션 로그 파일을 읽어 Elasticsearch로 보내는 역할을 합니다.
  • otel-collector: OpenTelemetry 데이터를 수집하고 Jaeger로 전달하는 역할을 합니다. 이 컨테이너는 모든 트레이스 데이터를 단일 지점에서 처리하는 역할을 합니다.

추가적으로 아래 설정 파일들도 추가가 필요하다


3. 애플레키에션 로깅 설정


<configuration>
    <appender name="CONSOLE" class="ch.qos.logback.core.ConsoleAppender">
        <encoder>
            <pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} [%X{traceId}] [%X{spanId}] - %msg%n</pattern>
        </encoder>
    </appender>
    <root level="info">
        <appender-ref ref="CONSOLE"/>
    </root>
</configuration>


4. 최종  


728x90

'코드 > dev' 카테고리의 다른 글

쿠버네티스 실습(minikube)  (0) 2026.02.22
쿠버네티스  (0) 2025.11.21
확장성을 고려한 CI/CD 구축 방법 -3  (0) 2025.09.22
확장성을 고려한 CI/CD 구축 방법 -2  (0) 2025.09.17
확장성을 고려한 CI/CD 구축 방법 -1  (0) 2025.09.12
728x90

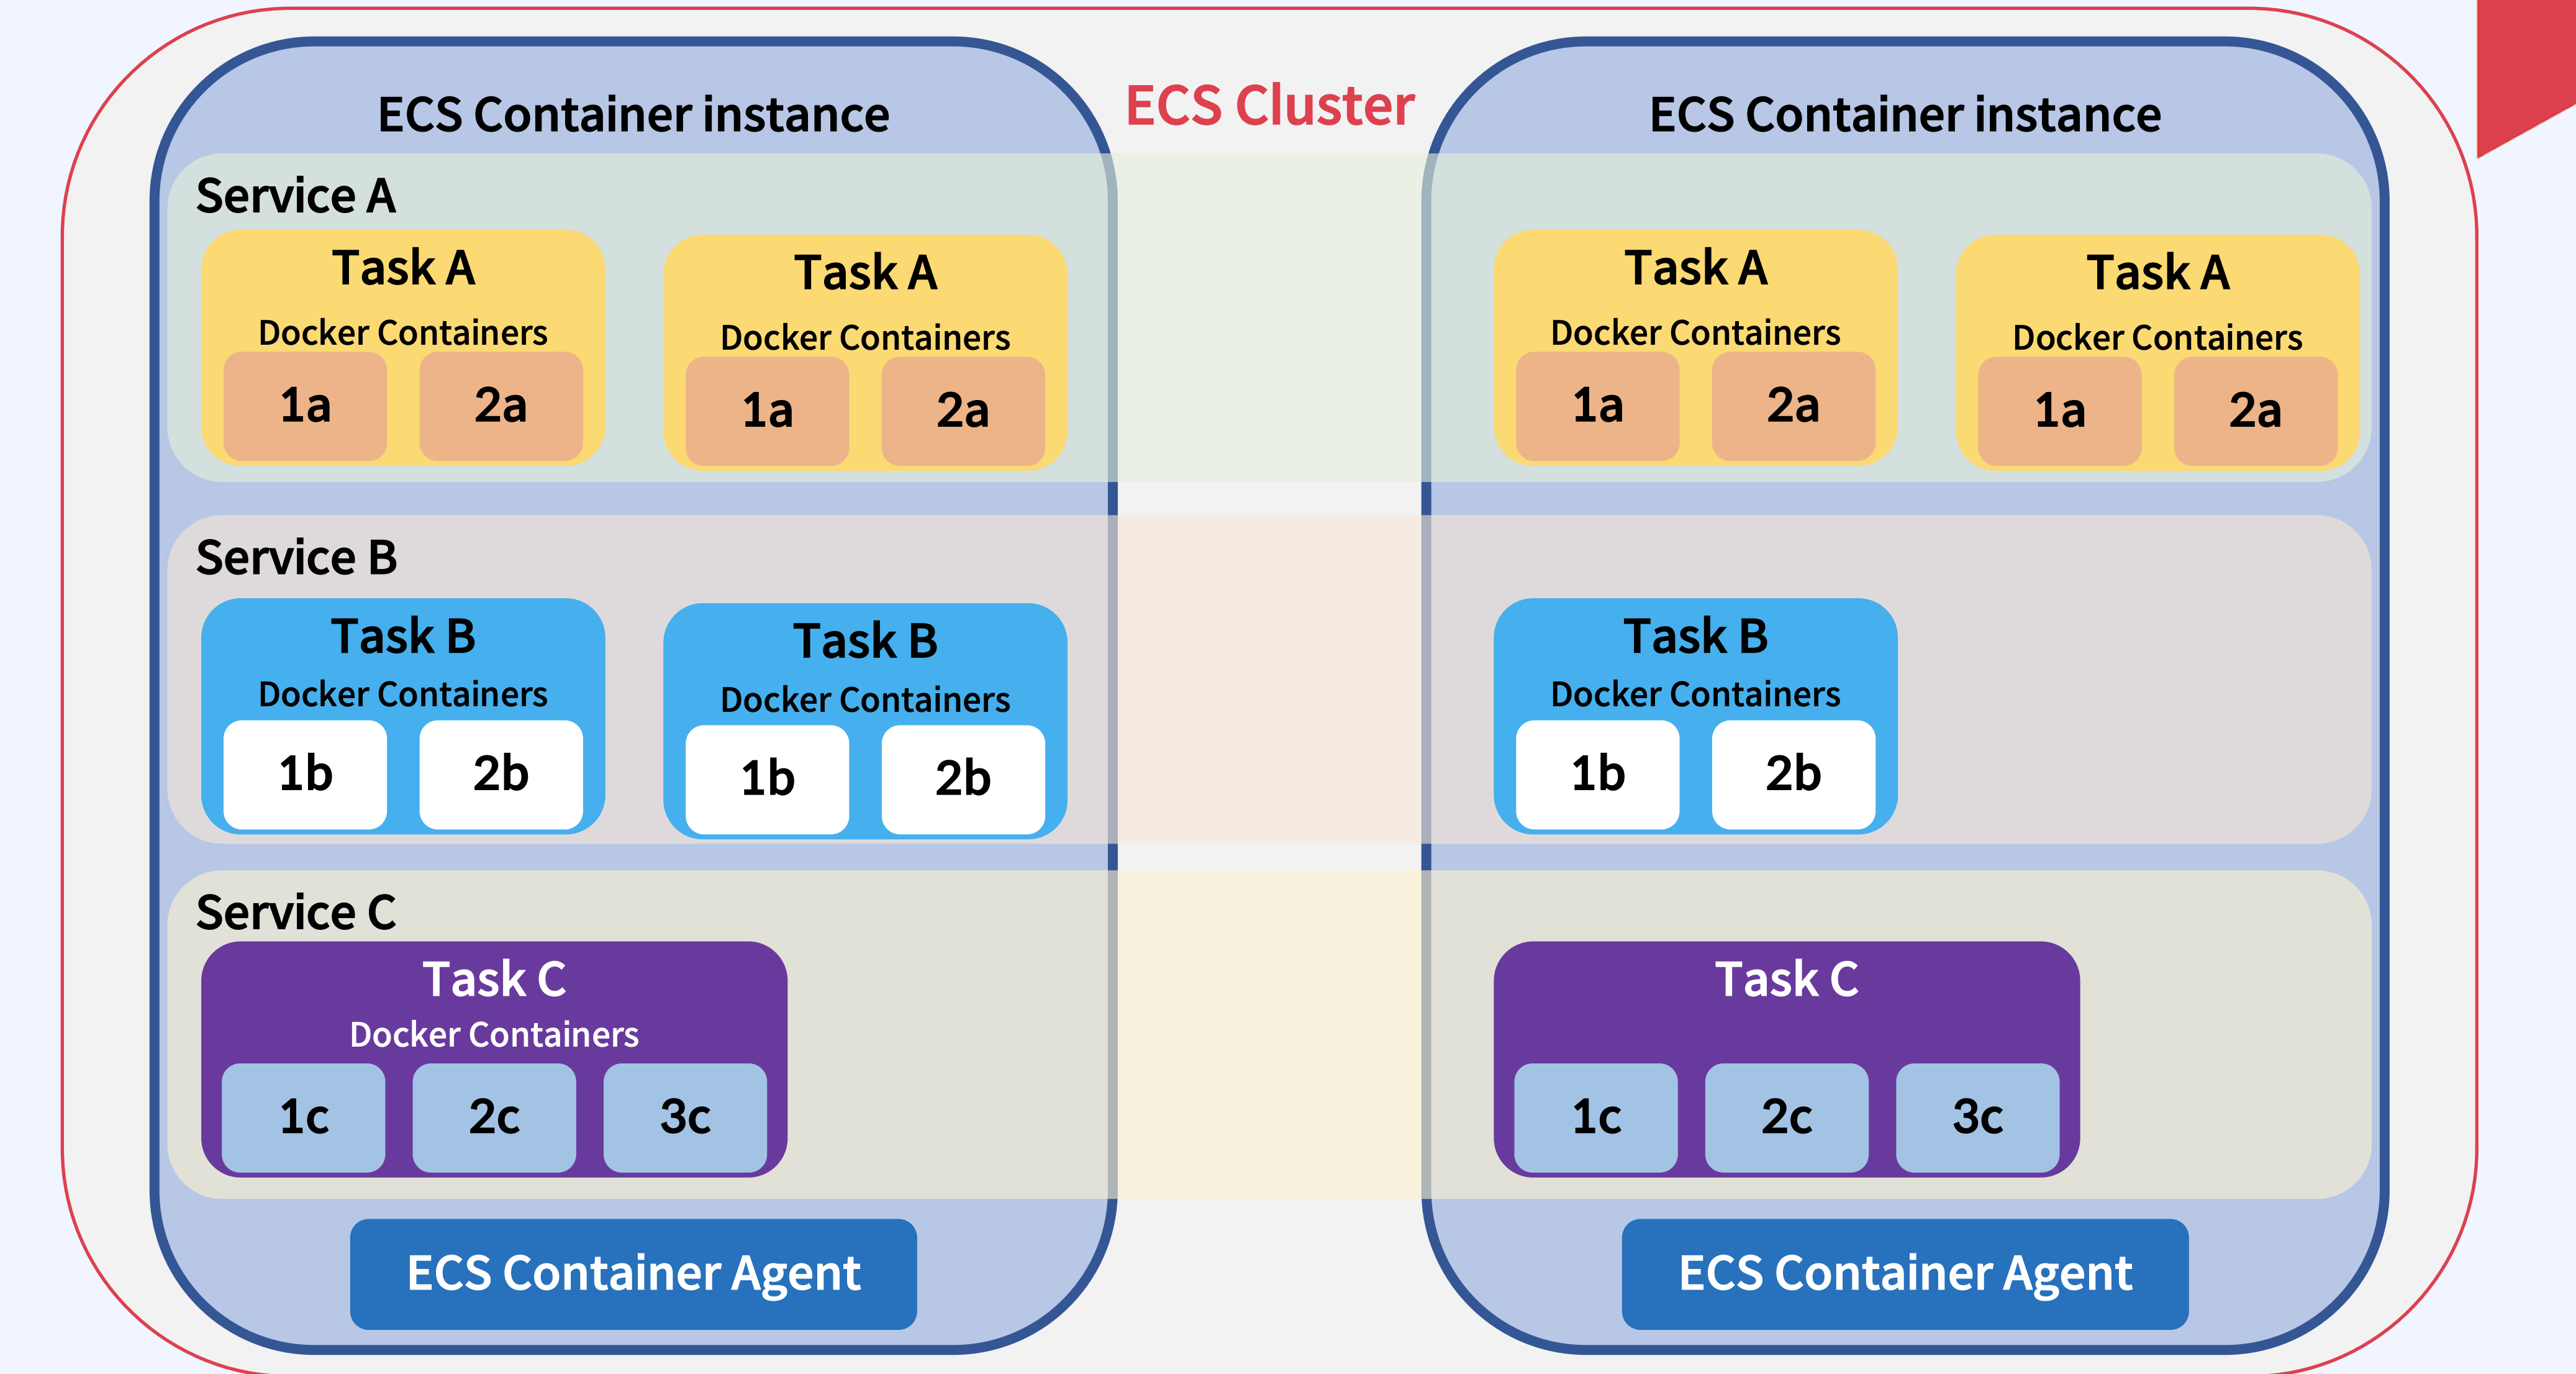
ecs 컨테이너 예시


이번에는 ECS 활용하여  배포서비스를 만들려고한다. ecs는 기본적으로  롤링 배포가 가능하다. 이를 활용하여 배포 파이프라인을 쉽게 만들어보고자 한다. 


일단 롤링 배포를 간략하게 설명하면 


롤링 배포는 가장 일반적인 무중단 배포 방식 중 하나이며,  기존의 오래된 버전(Old Task)을 새로운 버전(New Task)으로 하나씩 점진적으로 교체하는 방식이다. 이 과정에서 구 버전과 신 버전이 공존하며 트래픽을 처리하기 때문에, 서비스 중단 없이 배포를 완료할 수 있다.


1. AWS 설정

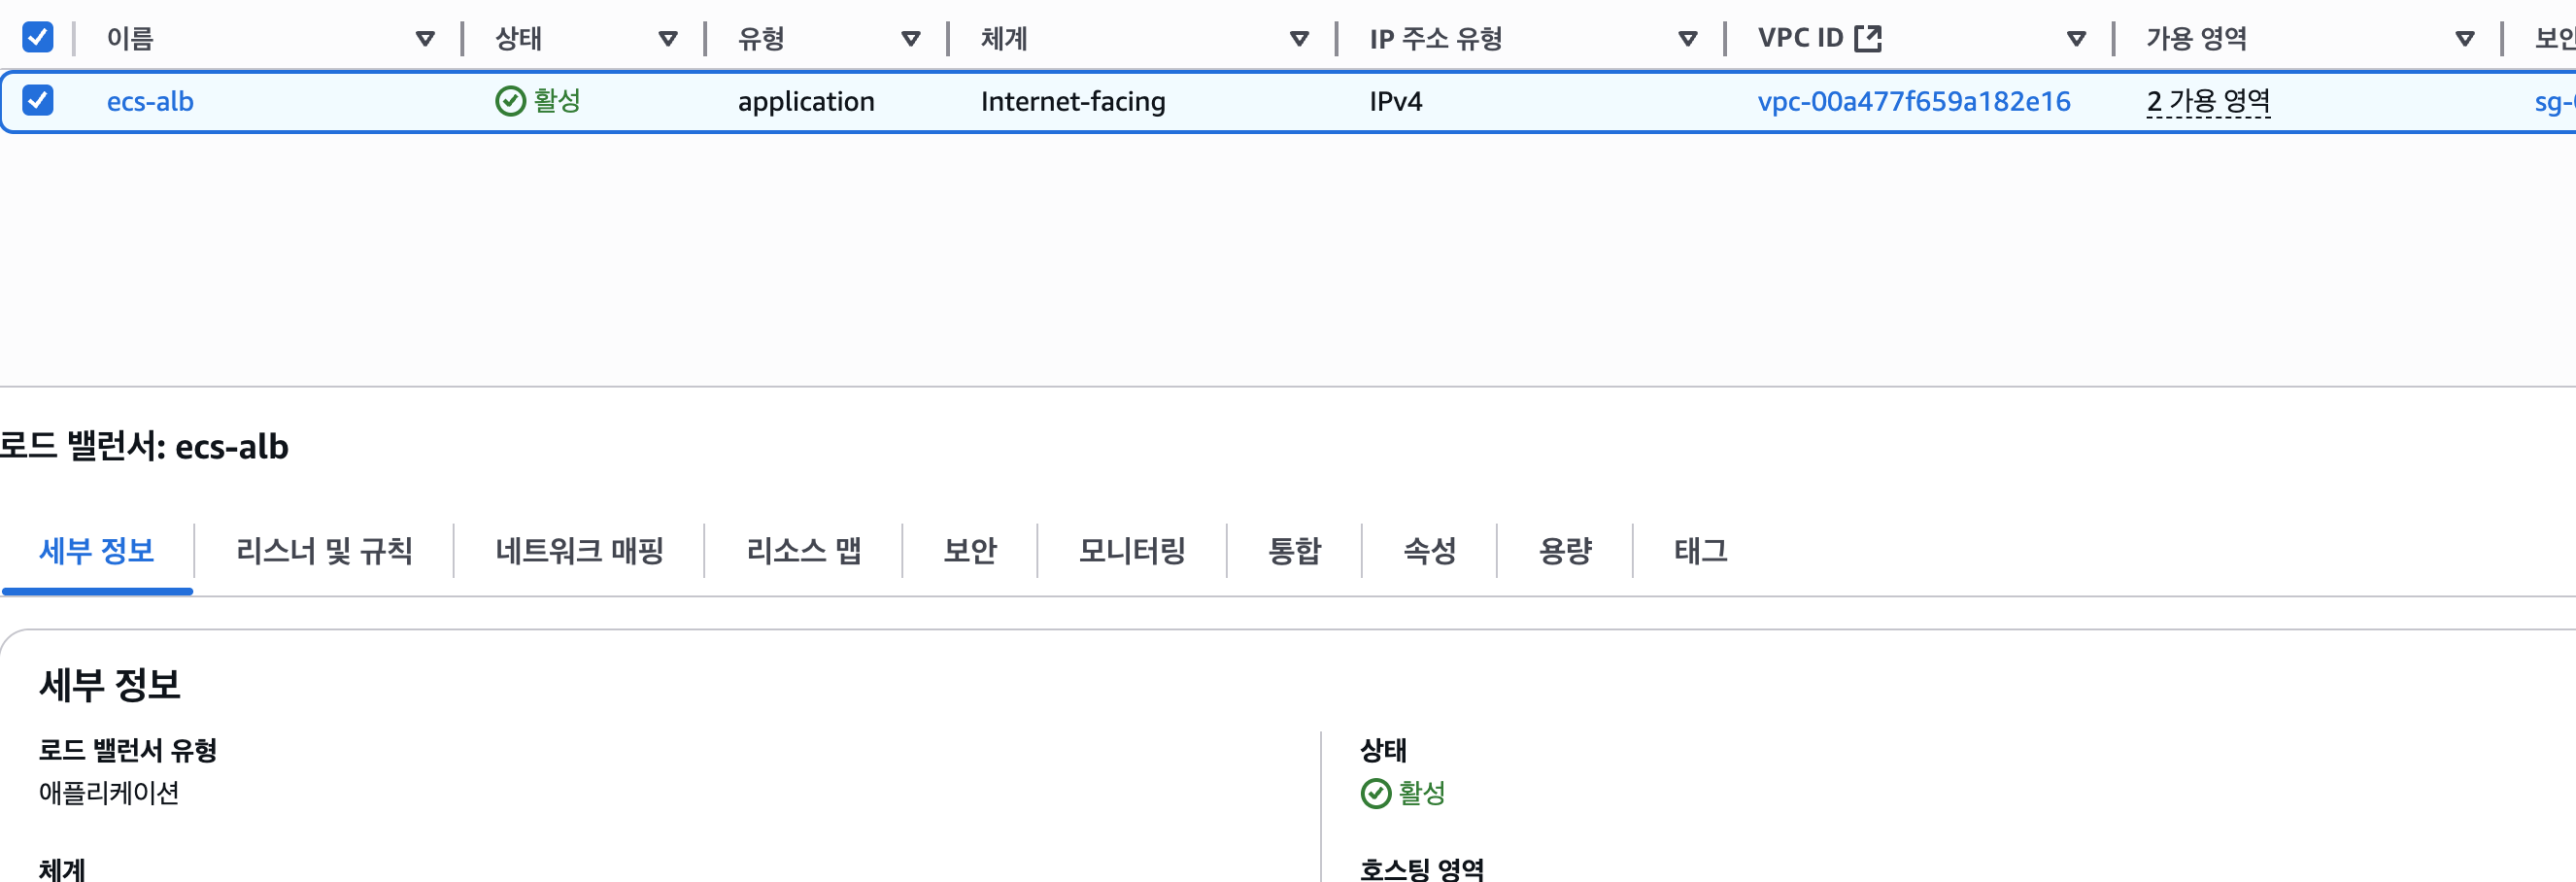
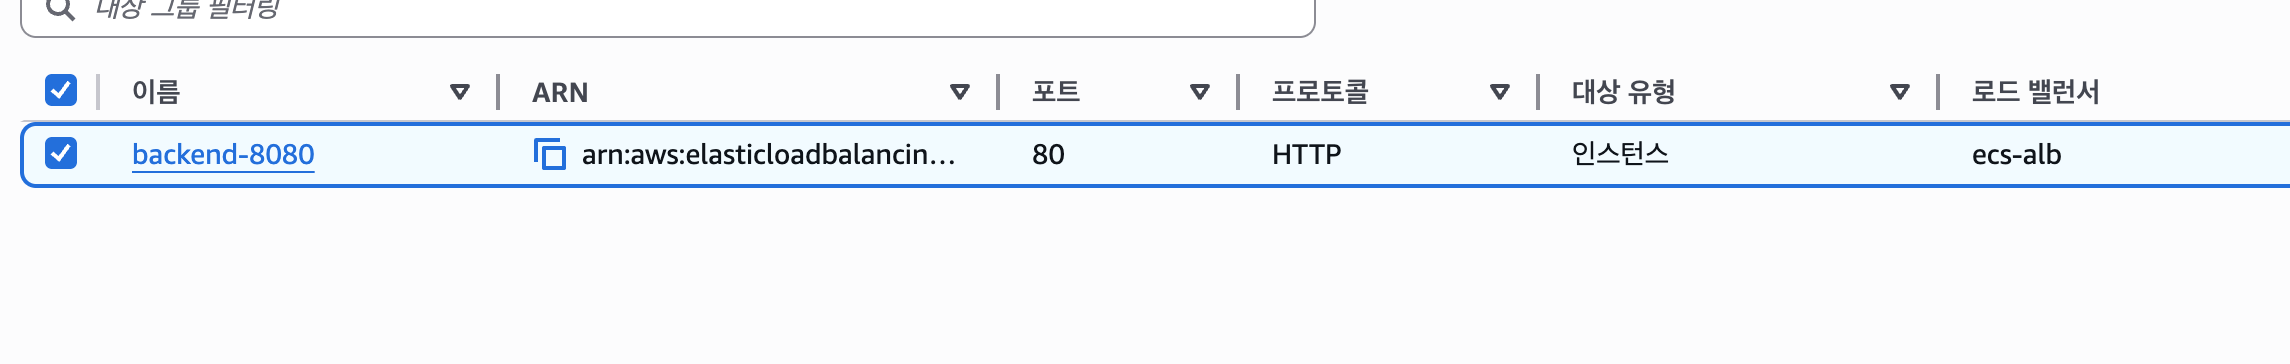
이전 과 마찬가지로 로드밸런서 및 그룹 설정


ALB


그룹


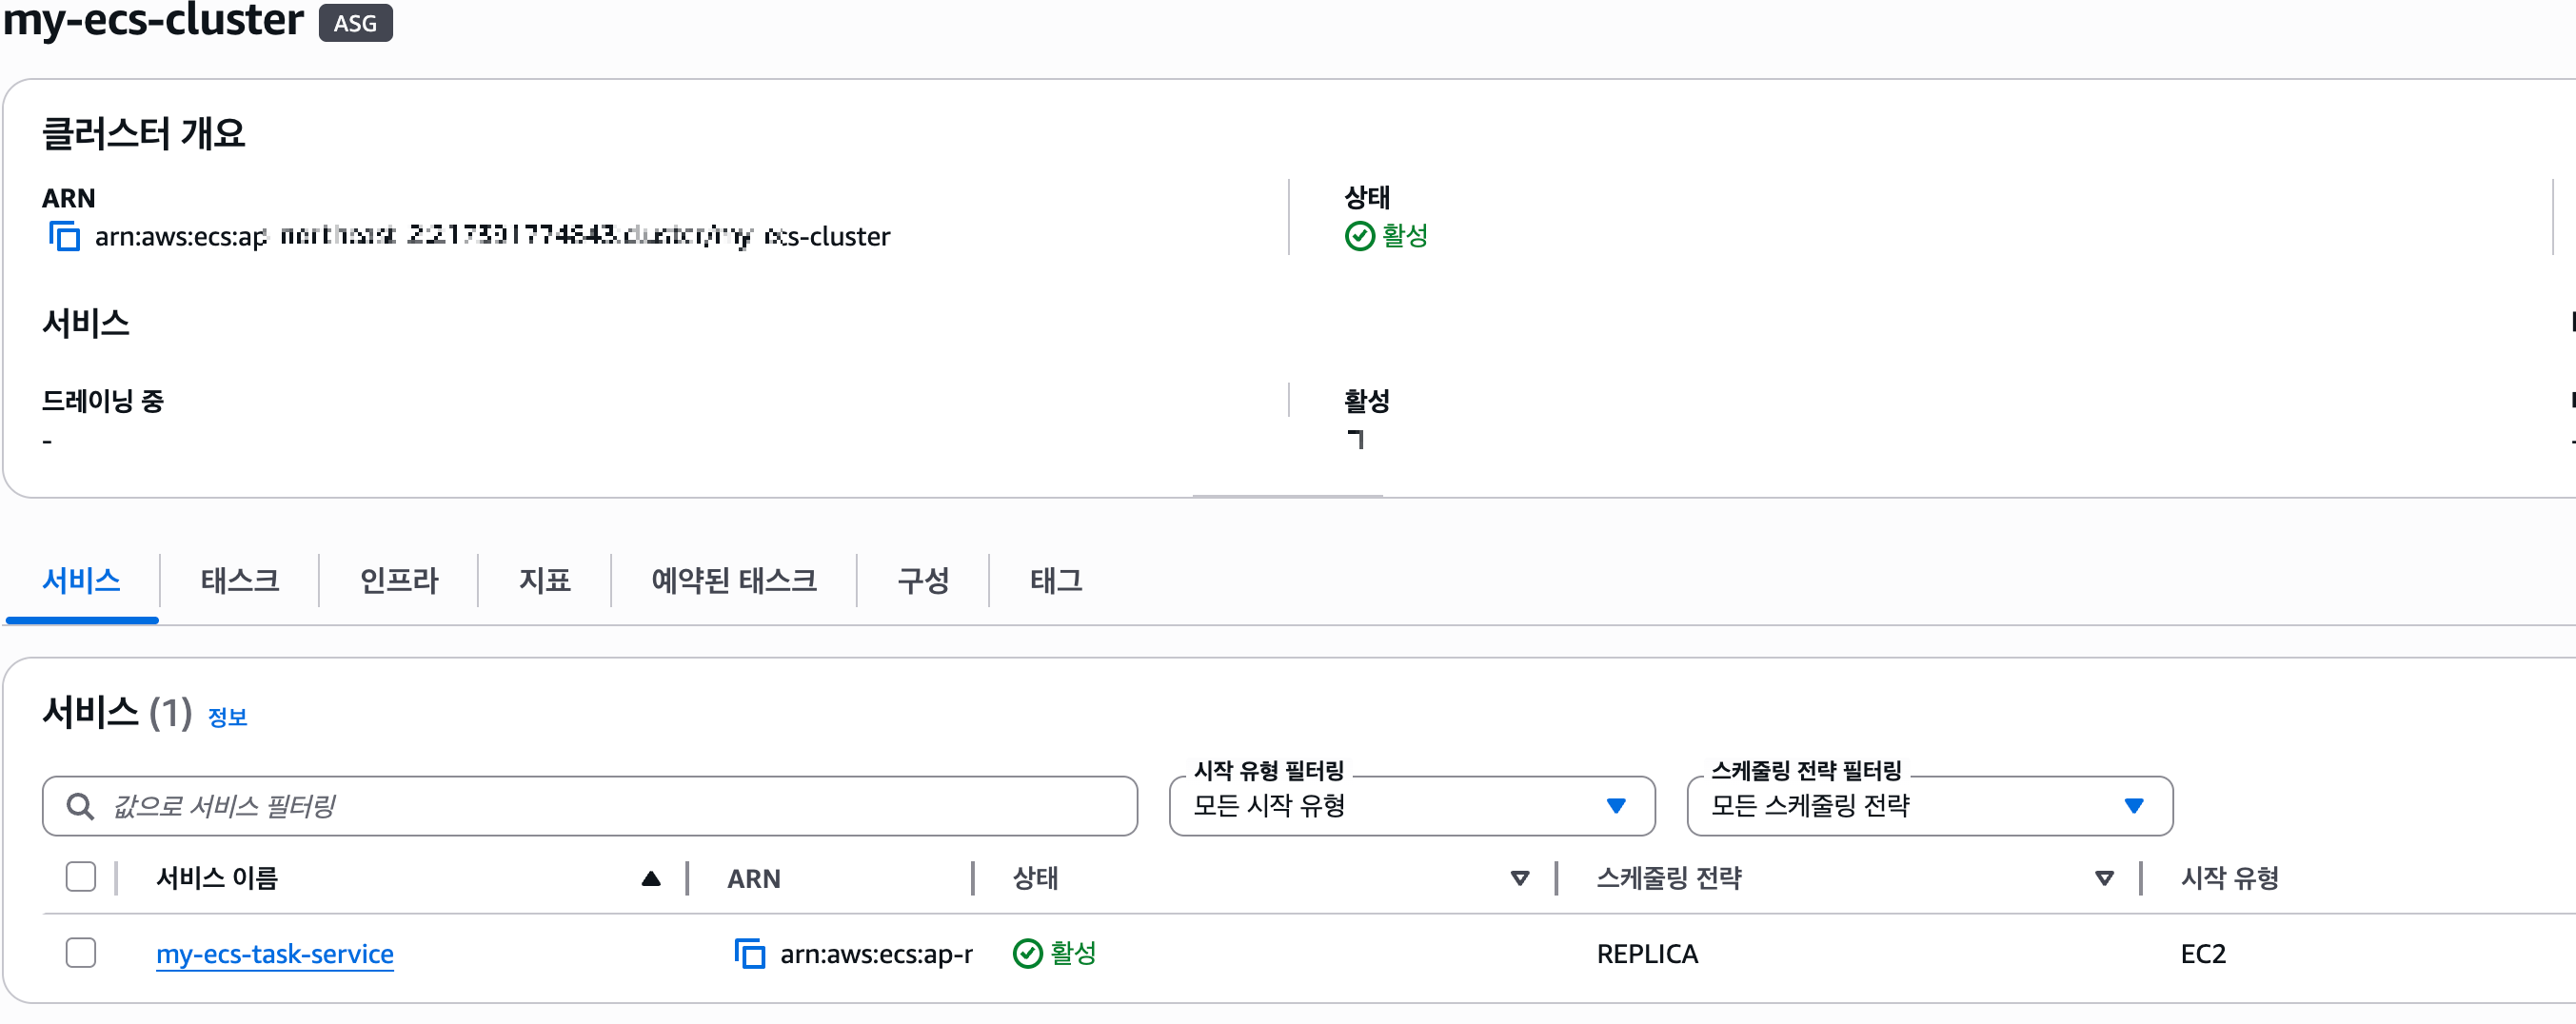
ECS 클러스터 및 서비스 


*클러스터 관련 주의사항  인스턴수 최소 수량 체크 및    컨테이너 포트 같은 것들은 꼭 잘 확인하고 진행하기 바란다.


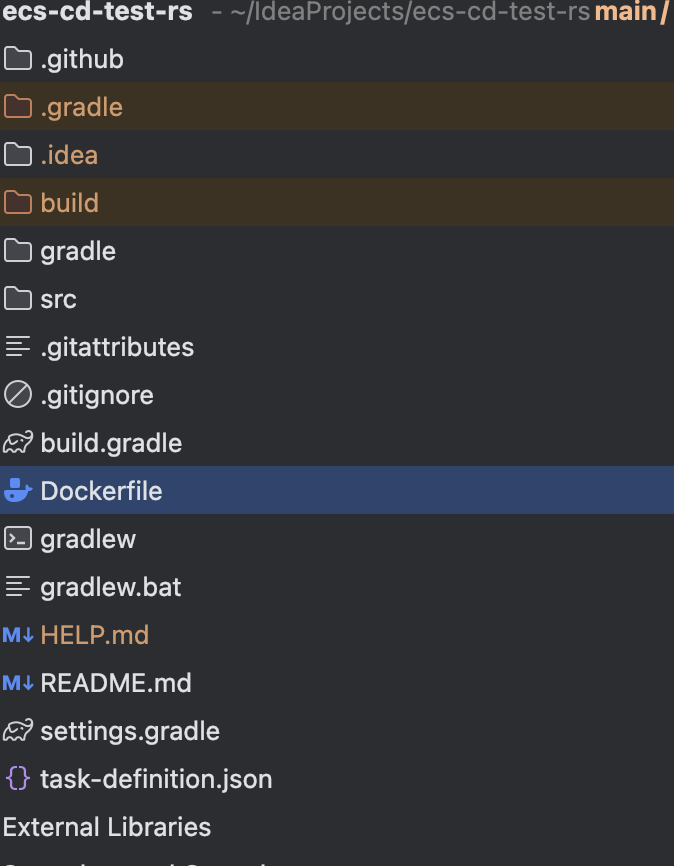
3.  배포관련 설정 파일

배포관련 파일은 작업을 정의하는 task definition 과  dockerFile,  deploy.yml 이 필요하다


위관련 파일들은 그렇게 여럽지 않게 진행 가능하다.

*실전에 녹일려면 기본 클러스터 크기나 인스턴스 크기  최대 인스턴스 수등 이렇것들은 꼭 다시 확인해야할듯하다.


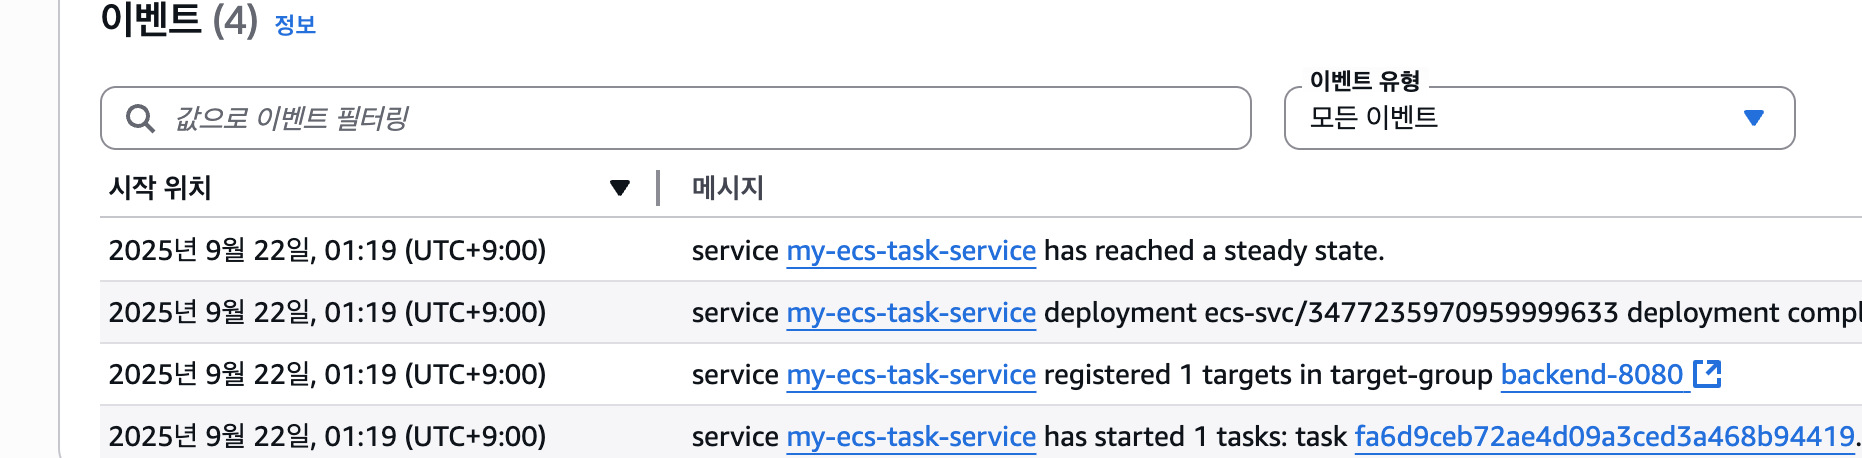
4.최종 이벤트 확인 결과


5. 보완 혹은 아쉬운점


프리티어 수전에서는 아쉬운 부분이 많다.  

금액적인 제한만 없다면  좀더 완성도 있게도 개인이 만들 수 있지 않을까 싶다.

728x90

'코드 > dev' 카테고리의 다른 글

쿠버네티스  (0) 2025.11.21
Jaeger와 Kibana로 로그통합  (1) 2025.09.24
확장성을 고려한 CI/CD 구축 방법 -2  (0) 2025.09.17
확장성을 고려한 CI/CD 구축 방법 -1  (0) 2025.09.12
자바 쓰레드 덤프(Thread Dump)  (0) 2025.09.12

+ Recent posts